深挖-分块策略实测
一句话理解
「分块该切多大」这个问题,我在自己的 131 万字笔记上真跑了一遍。结论和教科书不一样:在本来就有标题结构的文档上,「按标题切」比任何固定字数都强,而且强得不是一点。
零基础理解
想象你要把一本菜谱拆成卡片,方便做菜时快速抽到需要的那张。
方法一,固定张数:每 10 页拆一张卡。问题是菜谱的章节不会正好落在第 10、20、30 页——「红烧肉」的做法可能前半段在第 9 页、后半段在第 11 页,被撕成两张卡。
方法二,按小节拆:菜谱本来就有「红烧肉」「糖醋排骨」这样的小标题,一个标题下一张卡。每张卡都完整。
常识会说方法二更好。但很多做 AI 检索的人用的是方法一,理由是「业界经验说 512 个字一块最好」。这段经验来自处理网页和论文——那些东西没有整齐的小标题。
我的笔记大部分有。 439 个笔记文件(就是 .md 这种纯文本笔记)里,306 个(约七成)是「## 开头的二级标题 + 正文」的结构(## 是笔记软件里表示标题的写法,## 越多标题越小)。所以我怀疑那套经验值在我这儿不适用,就去测了。
实验怎么做的
三件事,不需要看懂代码也能理解:
-
语料(拿来测的这批材料):我自己笔记目录下的 439 个文件,共 131 万字。
-
出题:从每个小节里随机抽一句话当作「读者提问」。比如真的抽到过这一句:「数据多了,噪声就『平均化』了,模型被迫去学更通用的规律而不是死记硬背」(来自「解决过拟合」那一节)。一共 400 道题。正确答案就是这句话所在的那个小节。
-
打分:用不同的分块方法切碎语料,然后拿这 400 道题去检索,看能不能找回原小节。同时记录两个数:
- 找对率:第一名有没有找对。
- 信噪比:找回来的那块内容里,有多大比例是真的有用。信噪比 20% 意味着你喂给 AI 的上下文(也就是你塞进提问里的那些资料)里,八成是废话。
检索用的是 BM25,一种靠「词有没有对上」来找的老办法,不需要任何 AI 模型和显卡就能跑,所以结论能被完整复现(复现 = 别人照着做,也能得出一样的结果)。
结果
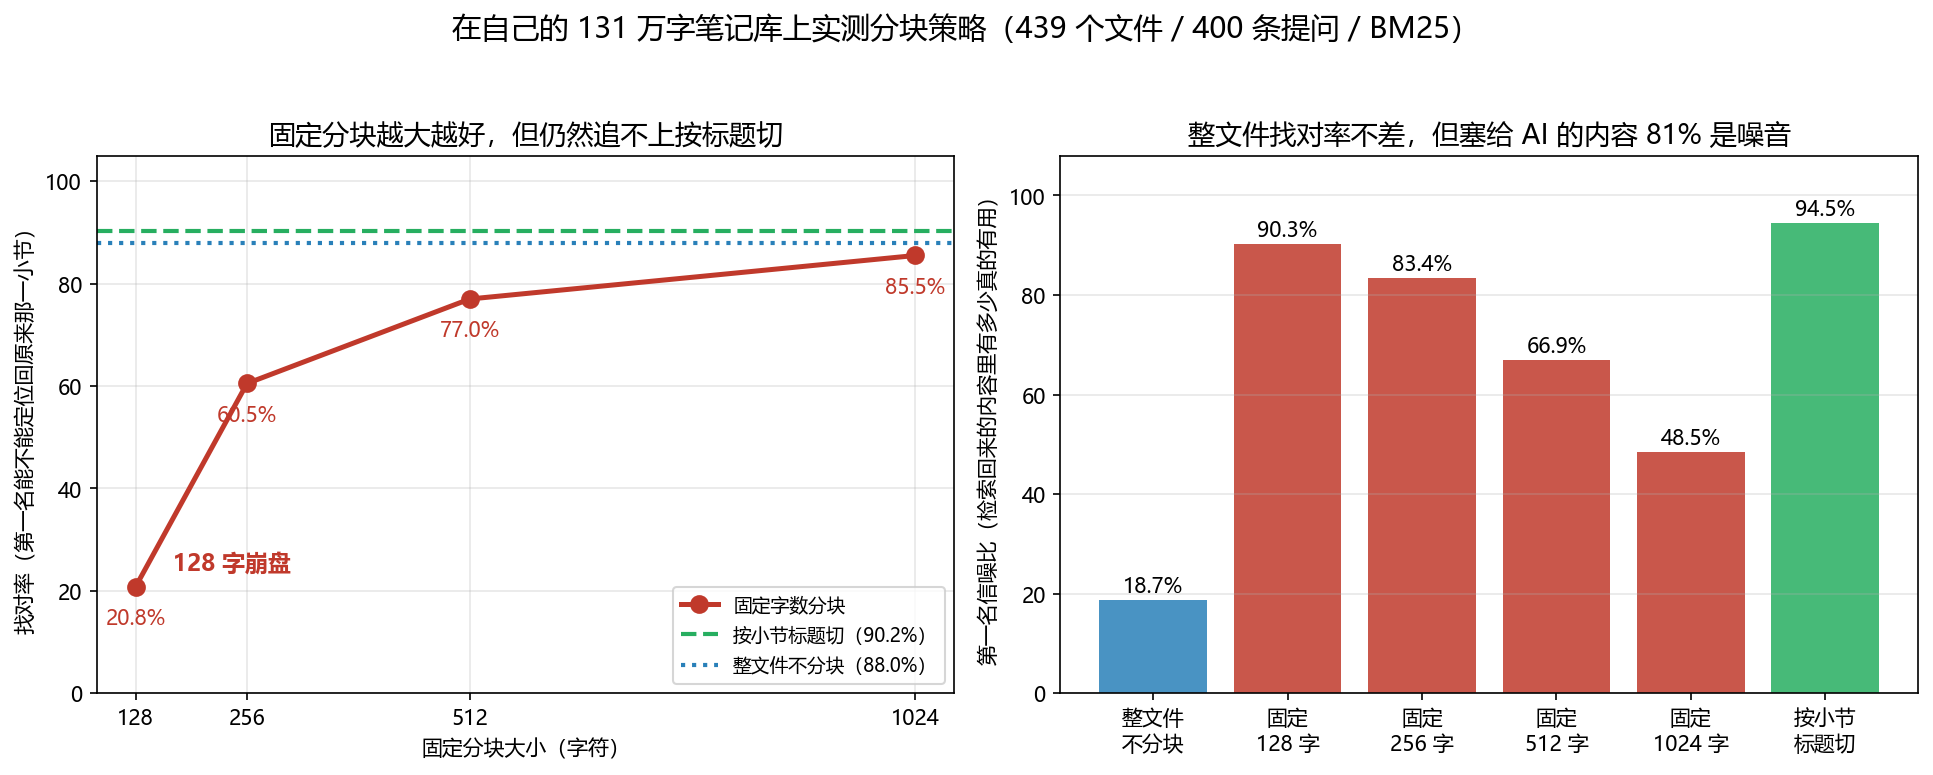
左图:能不能找回原来那一小节。右图:找回来的内容里有多少真的有用。
下表的「重叠」指相邻两块故意共用一段内容,为的是不让关键信息正好卡在切口上。
| 分块方式 | 切成几块 | 找对率(第一名) | 找对率(前五名) | 信噪比 | 每条查询耗时(毫秒) |
|---|---|---|---|---|---|
| 整文件不分块 | 439 | 88.0% | 95.2% | 18.7% | 1.1 |
按 ## 小节切 | 2146 | 90.2% | 94.8% | 94.5% | 1.7 |
按 ## 小节切 + 标题拼进正文 | 2146 | 90.2% | 95.0% | 94.5% | 2.2 |
| 小节优先,超 1024 字再切 | 2371 | 90.2% | 94.2% | 96.1% | 1.9 |
| 固定 128 字 | 10419 | 20.8% | 23.5% | 90.3% | 4.3 |
| 固定 256 字 | 5315 | 60.5% | 66.8% | 83.4% | 3.4 |
| 固定 512 字 | 2770 | 77.0% | 84.5% | 66.9% | 2.7 |
| 固定 1024 字 | 1488 | 85.5% | 93.5% | 48.5% | 2.1 |
| 固定 256 字 + 相邻块重叠 20% | 6552 | 61.8% | 69.8% | 85.5% | 5.0 |
| 固定 512 字 + 相邻块重叠 20% | 3323 | 80.2% | 86.2% | 72.1% | 3.6 |
(耗时那一列每次跑都会有出入,看个大概就行,别当精确值。)
五条结论
一、固定分块越大越好,但到 1024 字还是追不上按标题切
固定分块从 128 涨到 1024,找对率一路从 20.8% 爬到 85.5%,没有出现教科书说的「过了 512 就变差」那个转折点。同时按标题切稳稳站在 90.2%,比 1024 字还高 4.7 个百分点,而块数只有 2146 块——比固定 512 字的 2770 块还少。
为什么:小块容易把「一个完整的解释」拦腰截断。抽出来的那道题如果被切碎到两块里,检索到的任何一块都只覆盖答案的一部分,看起来就像「没找对」。大块不容易切断,但块越大,块里掺的无关内容越多——看下一列信噪比。
对我意味着什么:13.3 分块策略 —— RAG 的地基 里写的「256-512 是精度和完整性的平衡点」是针对网页和论文的。在我的笔记上,这个平衡点根本不存在——一路往大走更好,而真正的上限是按标题切。
二、128 字是崩盘,不是「差一点」
20.8% 意味着五次里有四次找不回来。这个档位的分块不是「精度差些」,是根本不能用。
为什么:128 字大约是一段话的长度。一个 ## 小节通常 300 到 800 字,被切成三到六块之后,没有哪一块能单独回答一个问题。这道题问的是「重排序的两阶段是什么」,检索给你的是「第一阶段叫初检」六个字——词对上了,意思没传过去。
三、重叠几乎不值那个价
256 字加 20% 重叠,找对率从 60.5% 升到 61.8%,只多 1.3 个百分点。代价是总块数从 5315 涨到 6552(多 23%)。512 字那一档也差不多,涨 3.2 个点、多 553 块。
为什么:重叠是为了救「关键信息正好压在切口上」这种事故。但按固定字数切本来就会产生大量切口,重叠只能护住其中一部分,而且重叠部分在两边各存一份,检索时会出现两块内容几乎一样、挤占前几名的情况。
真正解决切口问题的办法是不切在一段完整意思的中间——也就是按标题切。重叠是在补一个本来不该有的洞。
四、把标题拼进正文,一点用没有
「按小节切」和「按小节切 + 把该节标题拼在正文前面」的结果完全一样:90.2% 对 90.2%,信噪比 94.5% 对 94.5%。
为什么:有个挺有名的方法叫「上下文检索」,思路是给每个块补上它所在的章节信息。但在我这个语料上它没效果——因为笔记的小节标题和正文用词高度重合,「重排序」这一节的正文里本来就反复出现「重排序」。标题没带来任何正文里没有的信息。
适用范围:如果文档是那种标题写得很抽象、正文用词完全不同的类型(比如法律条文),这个方法应该仍然有用。我这里的结论只说明:别默认它有用,先测。
五、整文件不分块是最大的陷阱
整文件那条最容易被看漏:找对率 88.0%,看着不比按小节切的 90.2% 差多少。但信噪比只有 18.7%——你检索回来一整个文件,里面八成以上的内容和问题无关。
为什么:不分块时,是拿整个文件去和问题算一个总分。文件够大、又刚好包含答案,分数自然不低。可你拿到的东西没法直接用:一个文件几千字,AI 要在一堆无关内容里自己找到那一段。这既烧钱(AI 按字数收费,你塞多少进去就付多少钱),又容易把 AI 带偏。
对我意味着什么:这是「长上下文能不能替代检索增强」这个争论的一个具体反例。(检索增强的英文缩写是 RAG,做法是先从你自己的资料里找出相关片段,再交给 AI 回答。)如果直接把整篇塞进去,喂给 AI 的内容里 81% 是噪音。检索增强的价值不在于「能不能找到」,而在于「找到的东西干不干净」。
我漏掉的东西:题目本身有偏差
跑完发现按小节切有 21 道题没找对(400 道里的 5%)。我把这 21 道翻出来看,发现几乎全都是代码、表格和流程图被当成了提问:
H --> I[🤖 LLM 生成回答]—— 这是流程图里的箭头| SGD(随机梯度下降) | 每次用一个小批量数据计算梯度 | 6 |—— 这是表格的一行return llm_call(prompt)—— 这是代码### DeepSeek-R1 系列—— 这是更小的三级标题
这些根本不像真人会问的问题。也就是说,这 21 道「失败」里有相当一部分不是检索失败,是我出题出错了——我从正文里随机抽句子时,把代码和表格也当成了句子。
这件事本身是个教训:只看总分(90.2%)会以为那就是天花板,翻失败案例才知道还有多少是题目本身的毛病。 做检索测试时,失败案例比总分更值得看。
这些数字的适用范围
必须说清楚,免得把结论用过头:
- 测的是 BM25(对词),不是按意思找的检索(又叫语义检索、向量检索)。 换成后者,块大小的影响会不一样,那种检索用的 AI 模型对长文本更敏感。这里没测。
- 只有一个语料,就是我自己的笔记。它大体是结构化的(七成文件是「标题 + 正文」),所以「按标题切」天然占便宜。换成聊天记录、扫描件、没有小标题的长文,结论未必成立。
- 实验只覆盖了七成文件。 439 个文件里 306 个有
##小节(能切出块,也才能出题),另外 133 个只有更小的三级标题、或根本没有标题——它们既不产生题目也不产生块,等于完全没进这次实验。这带出一个部署上的坑:真要按##切,这 133 个文件会一块都切不出来,永远检索不到。真要上生产,得给它们兜底(退回到按段落或按固定长度切)。 - 题目是机器出的,不是真人提问,也没有人工核对过。真人提问会更短、更模糊、更口语,两个词而不是一整句。
- 判定「找对了」的标准是我自己定的:检索回来的那块内容,盖住原小节至少 30% 就算找对。 换成 50% 数字会变。
- 这些数字对应的是我写下这篇时的资料状态(439 个文件)。你往库里加笔记,数字会跟着变一点,重跑一次即可。
所以这段的结论应该这样读:它证明了「在我的笔记上按标题切明显更好」这件事,但没有证明「固定分块普遍不行」。
怎么复现
这一节是给会用电脑跑脚本的人看的。不看也不影响上面所有结论。
脚本在库里,改路径即可换语料:
python scripts/rag_chunking_bench.py    # 跑全部策略,输出结果表 + 失败案例
python scripts/rag_chunking_plot.py     # 重新出图到 assets/
跑实测只用 Python 自带的库和 numpy;出图那一步还要 matplotlib(画折线图的库)。不用装 AI 模型、不用显卡、不用联网。整轮跑完约 20 秒(视机器而定)。
这段实测反过来教我的东西
13.3 分块策略 —— RAG 的地基 结尾原话是:「最好的策略是针对你的文档类型做实验,用检索评估指标来验证。」
这句话是对的,但它是结论——读完你会点头,然后不会去做。只有当那张表是你自己的数字、128 字那个 20.8% 是你自己跑出来的时候,「针对自己的文档做实验」才从一句话变成一个习惯。
知识分两种:一种是读来的,能复述;一种是自己撞出来的,会改你的做法。这篇是后者的最小样本。
上级:13.3 分块策略 —— RAG 的地基 | 相关:稠密检索(深挖) | 混合检索(深挖) | 深挖-重排序
关联5
知识图谱局部图谱 · 点节点跳转